


Big data : entwicklung und programmierung von systemen für grosse datenmengen und einsatz der Lambda-Architektur
Autorzy
Ocena książki
Parametry
- 352 strony
- 13 godzin czytania
Więcej o książce
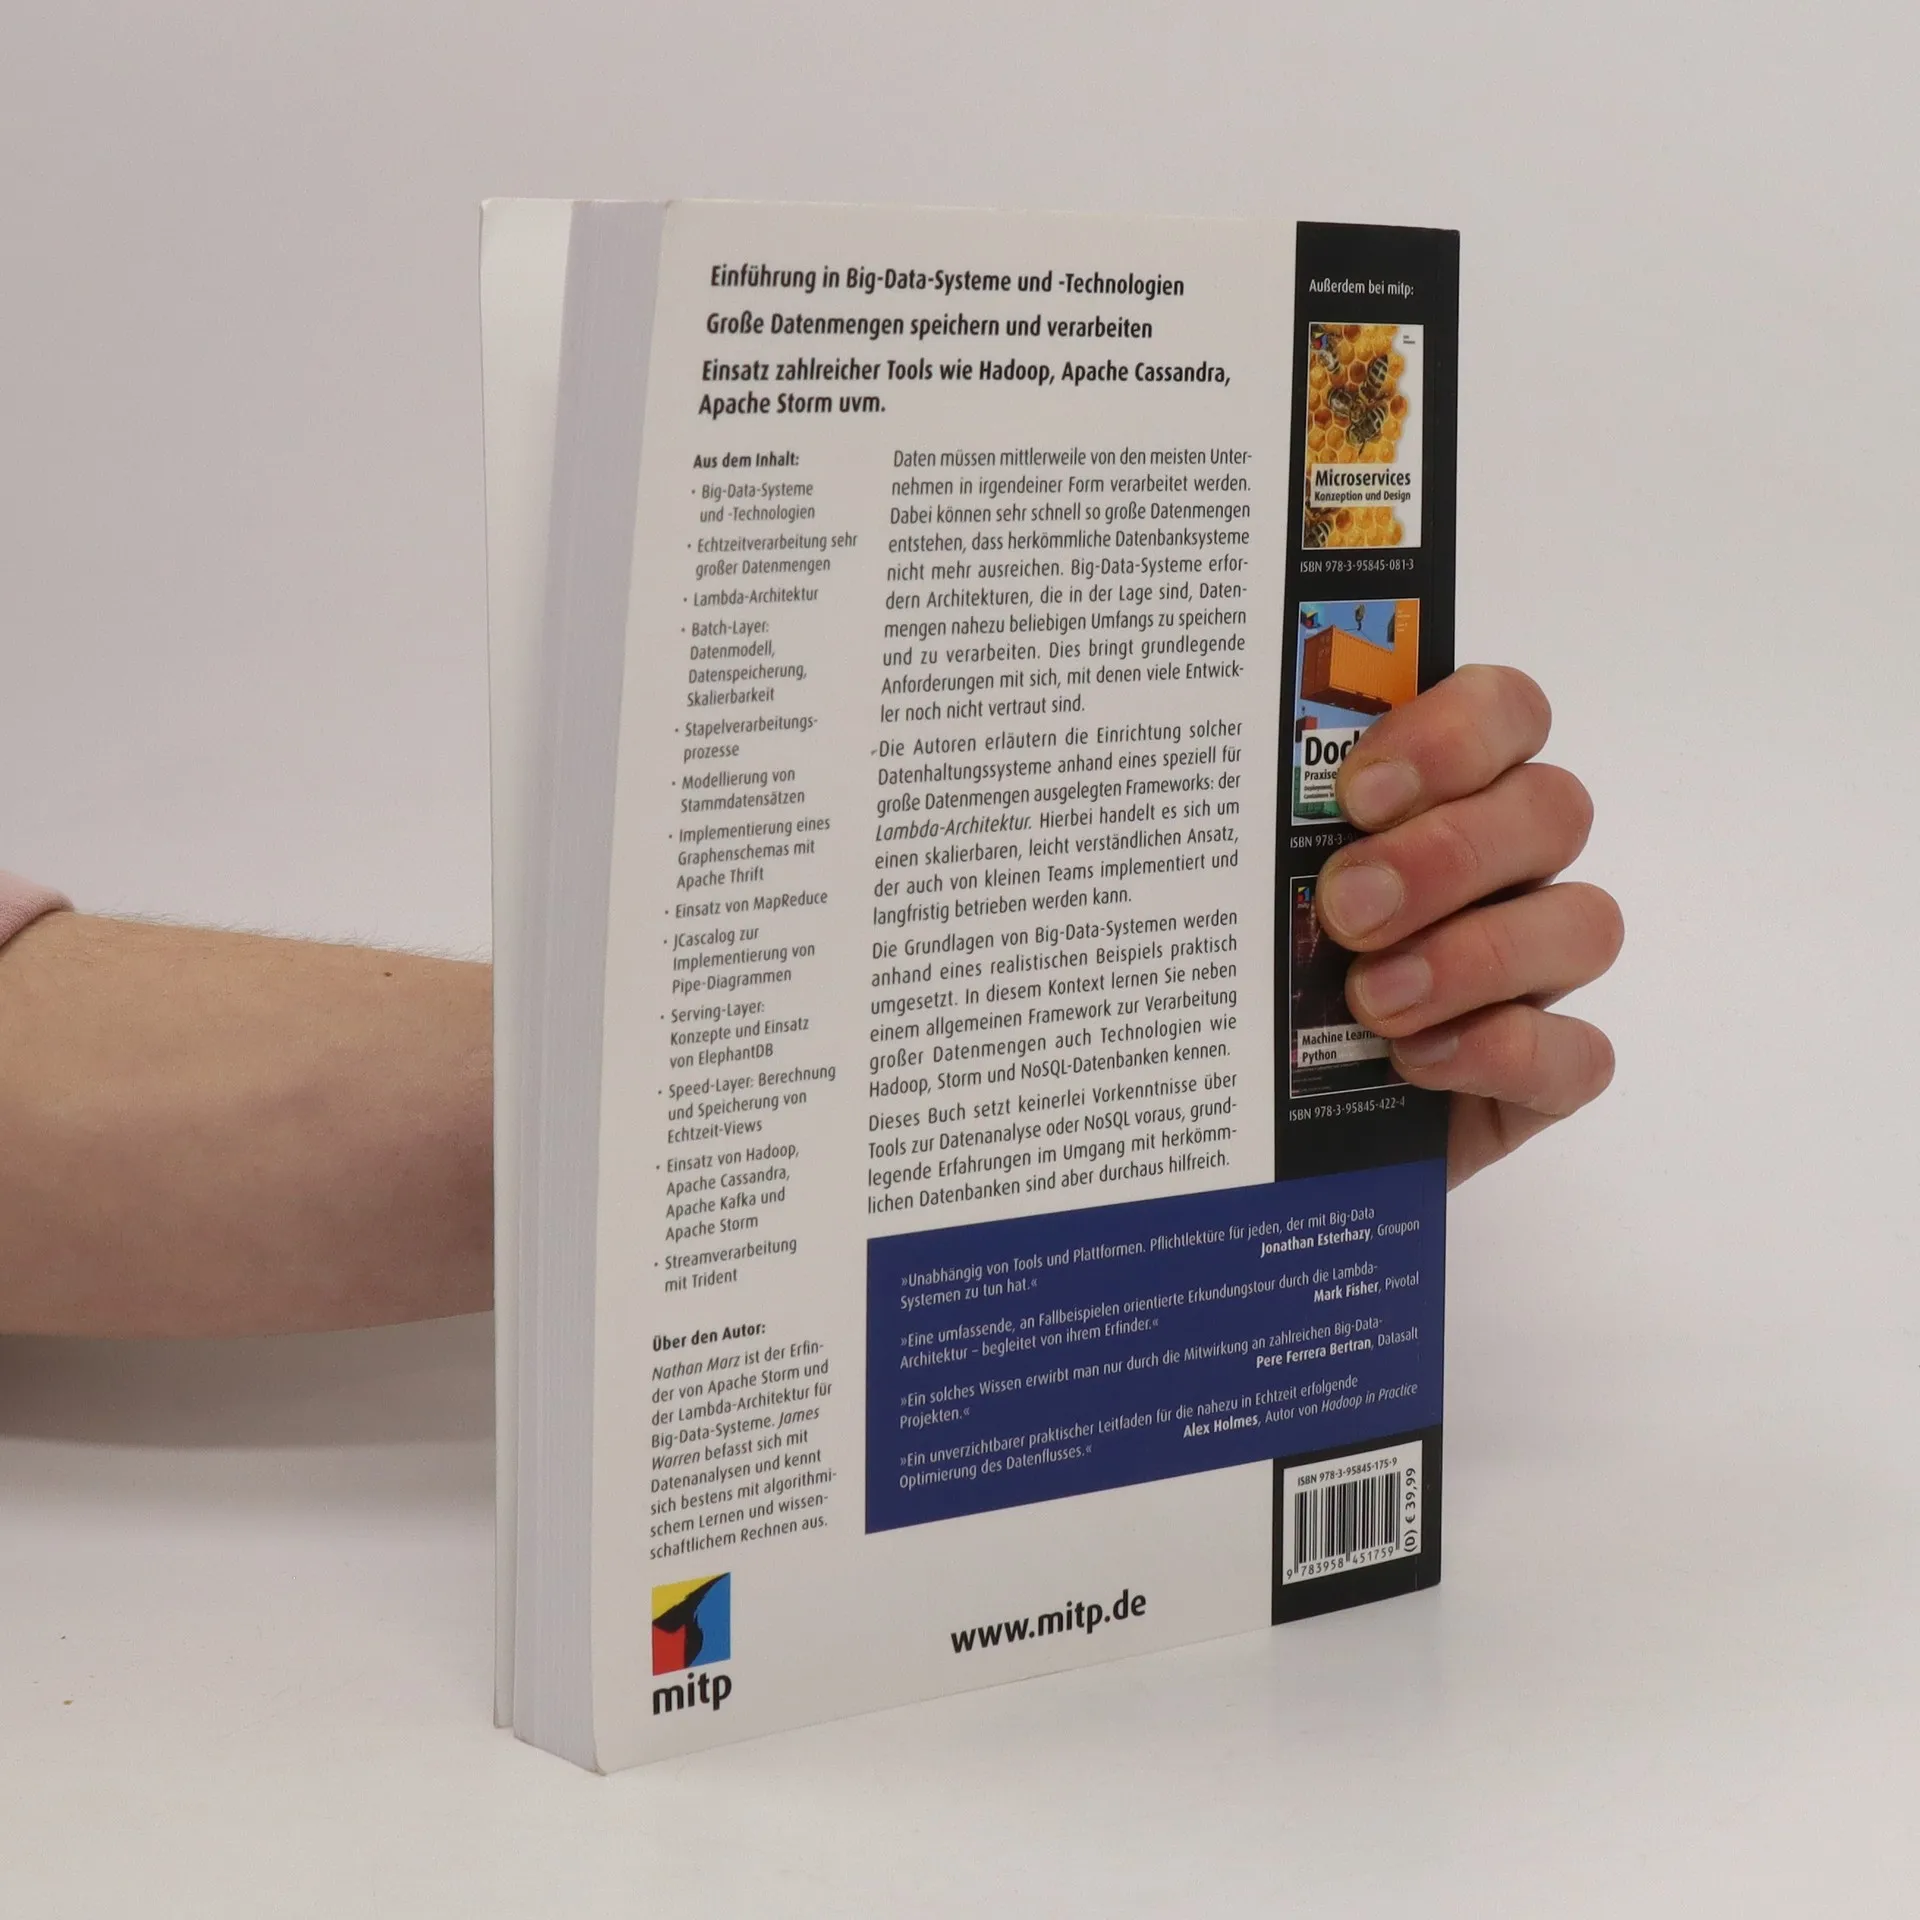
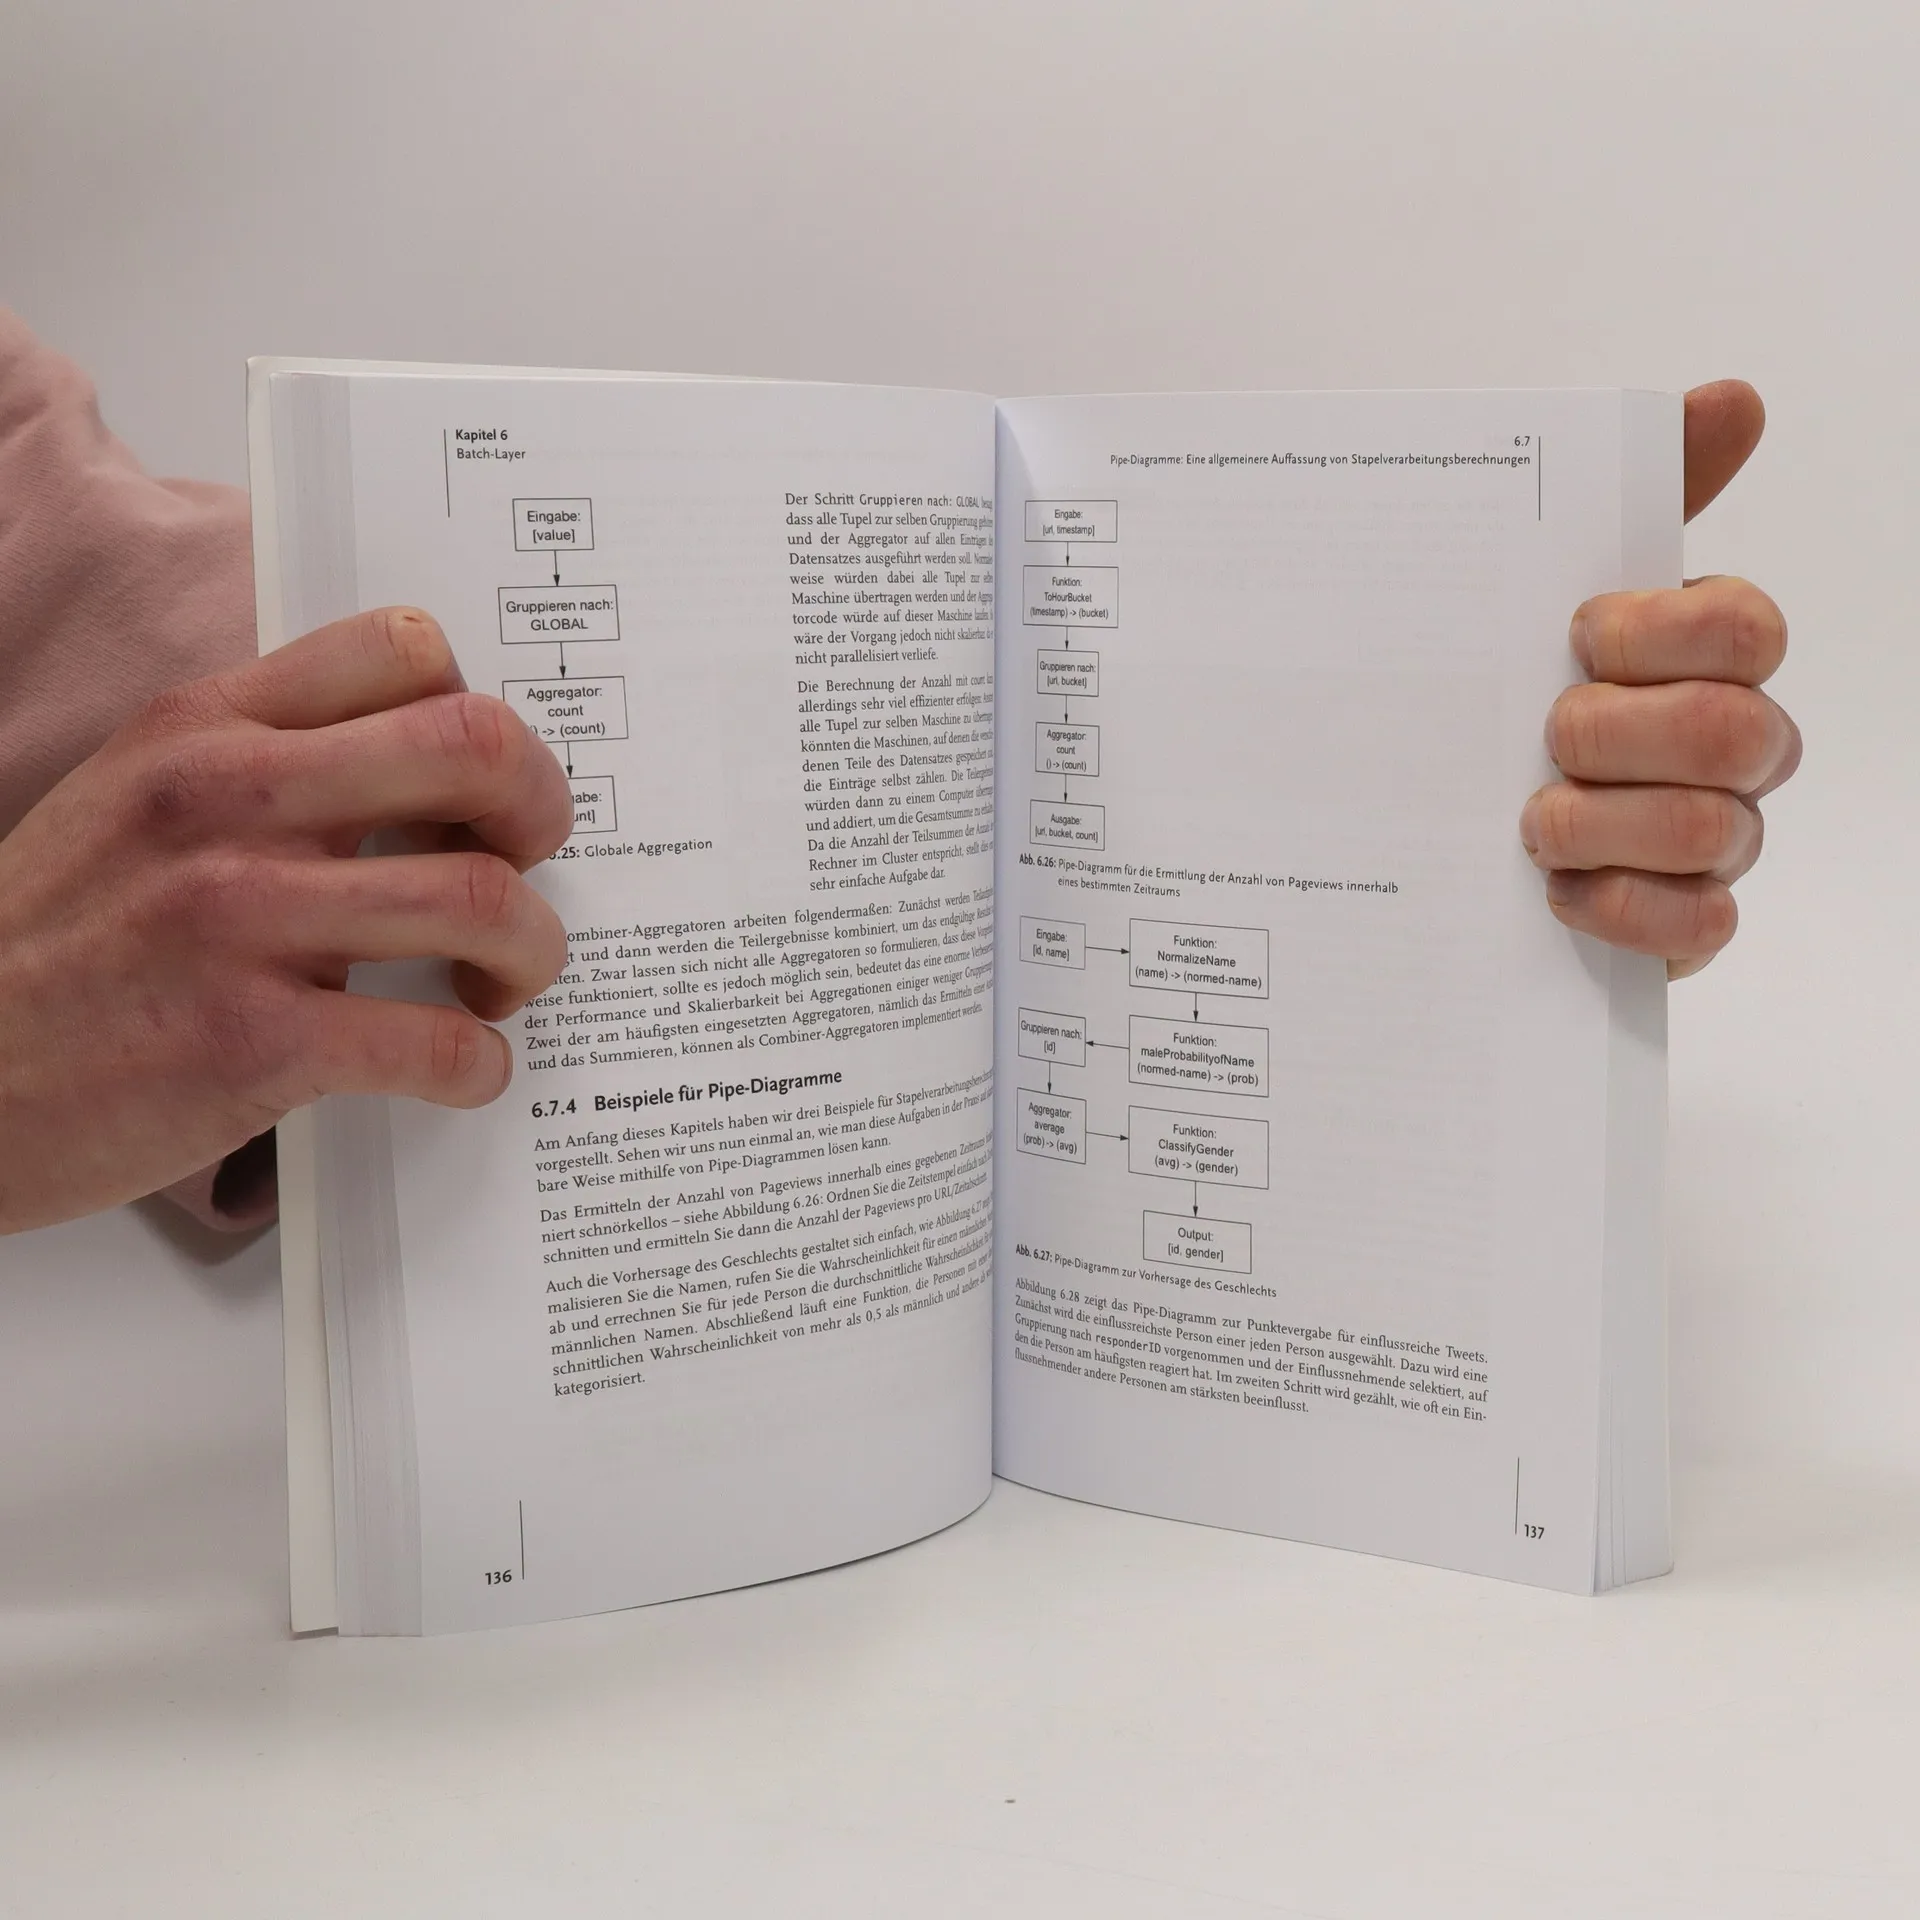
Die Verarbeitung großer Datenmengen ist für Unternehmen unerlässlich, da herkömmliche Datenbanksysteme oft nicht mehr ausreichen. Big-Data-Systeme erfordern spezielle Architekturen, die in der Lage sind, Daten nahezu beliebigen Umfangs zu speichern und zu verarbeiten, was grundlegende Anforderungen mit sich bringt, die vielen Entwicklern unbekannt sind. Die Autoren zeigen, wie man solche Systeme mit der Lambda-Architektur einrichtet, einem skalierbaren und leicht verständlichen Ansatz, der auch für kleine Teams geeignet ist. Anhand eines realistischen Beispiels werden die Grundlagen von Big-Data-Systemen praktisch umgesetzt. Dabei werden Technologien wie Hadoop, Storm und NoSQL-Datenbanken eingeführt. Das Buch setzt keine Vorkenntnisse über Datenanalysetools oder NoSQL voraus, jedoch sind grundlegende Erfahrungen mit herkömmlichen Datenbanken von Vorteil. Inhaltlich werden Themen behandelt wie Echtzeitverarbeitung großer Datenmengen, das Batch-Layer mit Datenmodellierung und Skalierbarkeit, sowie die Implementierung eines Graphenschemas mit Apache Thrift. Weitere Schwerpunkte sind MapReduce, JCascalog für Pipe-Diagramme, das Serving-Layer mit ElephantDB und die Speed-Layer für Echtzeit-Views. Zudem wird die Nutzung von Hadoop, Apache Cassandra, Apache Kafka und Apache Storm sowie die Streamverarbeitung mit Trident behandelt.

Zakup książki
Big data : entwicklung und programmierung von systemen für grosse datenmengen und einsatz der Lambda-Architektur, James Warren, Nathan Marz
- Język

- Rok wydania
- 2016
- Oprawa
- (miękka)
Metody płatności
Brakuje nam tutaj Twojej recenzji.
- Tytuł
- Big data : entwicklung und programmierung von systemen für grosse datenmengen und einsatz der Lambda-Architektur
- Język
- niemiecki
- Autorzy
- James Warren, Nathan Marz
- Wydawca
- mitp
- Rok wydania
- 2016
- Oprawa
- miękka
- Liczba stron
- 352
- ISBN10
- 3958451756
- ISBN13
- 9783958451759
- Seria
- Kategorie
- Ocena
- 3,8 z 5
- Opis
- Die Verarbeitung großer Datenmengen ist für Unternehmen unerlässlich, da herkömmliche Datenbanksysteme oft nicht mehr ausreichen. Big-Data-Systeme erfordern spezielle Architekturen, die in der Lage sind, Daten nahezu beliebigen Umfangs zu speichern und zu verarbeiten, was grundlegende Anforderungen mit sich bringt, die vielen Entwicklern unbekannt sind. Die Autoren zeigen, wie man solche Systeme mit der Lambda-Architektur einrichtet, einem skalierbaren und leicht verständlichen Ansatz, der auch für kleine Teams geeignet ist. Anhand eines realistischen Beispiels werden die Grundlagen von Big-Data-Systemen praktisch umgesetzt. Dabei werden Technologien wie Hadoop, Storm und NoSQL-Datenbanken eingeführt. Das Buch setzt keine Vorkenntnisse über Datenanalysetools oder NoSQL voraus, jedoch sind grundlegende Erfahrungen mit herkömmlichen Datenbanken von Vorteil. Inhaltlich werden Themen behandelt wie Echtzeitverarbeitung großer Datenmengen, das Batch-Layer mit Datenmodellierung und Skalierbarkeit, sowie die Implementierung eines Graphenschemas mit Apache Thrift. Weitere Schwerpunkte sind MapReduce, JCascalog für Pipe-Diagramme, das Serving-Layer mit ElephantDB und die Speed-Layer für Echtzeit-Views. Zudem wird die Nutzung von Hadoop, Apache Cassandra, Apache Kafka und Apache Storm sowie die Streamverarbeitung mit Trident behandelt.